[!] この記事は公開されてから1年以上経過しています。情報が古い可能性がありますので、ご注意ください。
OSS として仮想マシンや仮想ネットワークなどのクラウド環境を提供する OpenStack ですが、ここに Trove というサービスを加えることにより、データベースを簡単に構築、管理し、仮想マシンから利用できるようになります。
Trove が提供する各種データベースのサーバーは、該当の起動イメージをもとに作成される、仮想マシンインスタンス上で動作します。 この記事では、Trove の紹介から始め、OpenStack(Queens 版)環境に Trove を導入する際の要の作業となる、起動イメージの作成と、無事動作できるためのポイントまでを複数回にわたって説明します。
第 1 回目は準備段階として、Trove について説明します。
OpenStack の DBaaS(Database as a Service) ―― Trove
Trove は、OpenStack にデータベースサービスの機能を追加します。
データベースの管理には、デプロイ、設定、監視、バックアップ、リストア、レプリケーションやクラスターの構成・管理など、いくつもの手間が掛かる作業があるものですが、Trove の導入により、OpenStack の Dashboard を利用してこれらを簡単に行えるようになります。
また Trove は、SQL/NoSQL を含む複数種類のデータストアに対応しています。
Trove が提供するデータベース機能
エンドユーザーは、OpenStack Dashboard の Trove メニューを利用して、以下に挙げるようなデータベースの操作ができます。
-
データベースサーバーの起動と管理
データベースサーバーを起動したり、リサイズ、再起動などを行います。
-
データベース/データベースユーザーの管理
新規データベースやデータベースユーザーを作成し、データベースのアクセス許可を変更します。
-
バックアップ/リストア
データベースのバックアップを取得し、また、リストアをします。 サポートされていれば、差分/増分バックアップも利用できます。
※Trove のリストアでは、バックアップをもとにして新規にデータベースサーバーが起動されます。 -
データベースサーバーの設定
各種データベースサーバーの設定を一括管理し、データベースサーバーに適用させます。
-
データベースログ参照
データベースサーバーのログの開始/停止や取り出しを行い、Dashboard 画面およびダウンロードファイルにてログの中身を参照できます。
-
データベースレプリケーション
マスターと複数のリードオンリースレーブによる、データベースレプリケーション構成を構築し、スレーブの追加/削除やマスターの変更などの管理を行います。
-
データベースクラスター
データベースクラスターを構築し、ノードの拡張や縮小などの管理を行います。
なお、データストアの種類と Trove のサポート状況によって、使える機能・使えない機能はあります。
Trove がサポートするデータストア
Trove は、複数種類のデータストアに対応しています。
サポート状況が示されているデータストアは以下のとおりです。
※下記表は公式情報によりますが、長いこと更新されていないように見え、動作確認を取ってみると、最新状況に合っていないようにも見受けられます。細部は参考程度に注意して見た方が良いようです。リリースノートなどを辿ると、あらたに動作するようになった機能もありそうな一方、バージョンアップに伴うデグレードなども、もしかしたら起きているのかもしれません。
| Feature | MySQL | Redis | Cassandra | MongoDB | PostgreSQL | Couchbase |
|---|---|---|---|---|---|---|
| Launch | ✔ | ✔ | ✔ | ✔ | ✔ | ✔ |
| Reboot | ✔ | ✔ | ✔ | ✔ | ✔ | ✔ |
| Terminate | ✔ | ✔ | ✔ | ✔ | ✔ | ✔ |
| Resize | ✔ | ✔ | ✔ | ✔ | ✔ | ✔ |
| Backup | ✔ | ✔ | ✔** | ✔ | ✔ | ✔ |
| Restore | ✔ | ✔ | ✔** | ✔ | ✔ | ✔ |
| Replication | ✔ | - | - | - | ✔** | - |
| Clustering | - | ✔** | ✔** | ✔ | - | ✔** |
| Users | ✔ | ❌ | ❌ | ❌ | ✔ | ❌ |
| Schemas | ✔ | ❌ | ❌ | ❌ | ✔+ | ❌ |
| Root | ✔ | ❌ | ❌ | ❌ | ✔++ | ✔ |
** = Datastore supports it -- but it is currently Work in Progress in Trove.
+ = PostgreSQL supports has separate constructs for schemas and databases.
++ = PostgreSQL supports superusers but does not have a "root" user.
(https://wiki.openstack.org/wiki/Trove/DatastoreCompatibilityMatrix ⧉ より)
Trove 導入から利用までの流れ
Trove は複数種類のデータストアに対応していますが、初期導入時にすべてのデータストアを準備しなくても構いません。 あとから残りのデータストアに対応するために、起動イメージを追加で作成し、登録していくこともできます。
ここでは、Trove 導入から、起動イメージ作成、そしてユーザが利用できるまでの流れの概要を説明します。
初期導入の例
初期導入では、Trove 本体の導入と、初回提供分データベースサーバー起動イメージの作成・登録までを行うとすると、導入は以下の流れになります。
-
管理者作業
-
OpenStack 環境に Trove 本体を導入
OpenStack 公式サイトの Trove 導入手順(Queens 版) ⧉等を参考にして、Trove 本体部分を導入します。
Trove 用の Dashboard プラグイン導入については、Trove dashboard 導入手順(Queens 版) ⧉を参照します。
※他に、OS ごとに用意されたパッケージから導入できる場合もあります。 -
Trove 用のデータベースサーバー起動イメージを作成
同じく OpenStack 公式サイトの起動イメージ作成についての説明(Queens 版) ⧉等を参考にして、データベースサーバー起動イメージを作成します。
-
データストアと起動イメージを Trove に登録
同じく OpenStack 公式サイトの起動イメージ登録と前後の手順(Queens 版) ⧉で 3. Add a datastore to trove: - Create a trove image. よりあとの部分を参照し、起動イメージの登録と、データストアと起動イメージの対応付けを実施します。
※起動イメージ自体は OpenStack イメージサービス(Glance)に登録し、データストア・バージョンとの対応付けを Trove に登録しています。また、データベース設定パラメータの定義も読み込んでおきます。 Trove 管理者ドキュメント内のデータストアの登録手順(Queens 版) ⧉の 5. Load validation rules for configuration groups を参照して対応します。
※ここでは、MySQL 等以外ではスキップと書かれていますが、 他のデータストア用の定義ファイルも用意されているようです。
-
-
エンドユーザーの利用
-
Trove のデータベースサーバーを起動
OpenStack Dashboard を使って Trove のデータベースサーバーを起動します。
-
データストア追加導入の例
追加導入にて Trove で提供するデータストアの種類を増やす場合、導入は以下の流れとなります。
-
管理者作業
-
追加のデータベースサーバー起動イメージを作成
初期導入時と同様にして、新しいデータベースサーバー起動イメージを作成します。
-
データストアと起動イメージを Trove に登録
初期導入時と同様に、データストアと起動イメージの対応を登録します。
-
-
エンドユーザーの利用
-
Trove のデータベースサーバーを起動
OpenStack Dashboard を使って Trove の新しいデータベースサーバーを起動します。
-
Trove 本体の導入と起動イメージの登録については、OpenStack 公式サイトの情報等を参照しながらなんとかできてしまうでしょう。 しかし、起動イメージの作成については、無事ビルドが成功するまでと、作成したイメージが期待通り動くようになるまでで、ある程度の試行錯誤や想定外の問題の切り分け・対処等が必要になります。
※OpenStack (Queens 版)公式の導入手順は、そのまま倣って実行、設定しても動いてしまうことが多いのですが、Trove の導入手順では、中には注意が必要なこともあります。以下の点にとくに注意し、導入手順を参照します。
-
config ファイルの記載例が示されているが、内容の修正が必要なもの
- URL 等の記載が実際の設定内容と異なっているものがある
- trove-guestagent.conf で
trove_auth_url = http://controller/identity/v2.0となっているところは
trove_auth_url = http://xx.xx.xx.xx:5000/identity_admin/v3としないとうまく動かなかった- Trove guest agent 環境からの名前解決を不要とするために IP アドレスでの指定が必要
- ポートの指定が必要
- identity でなく identity_admin
- OpenStack(Queens 版)では Keystone の API v2.0 は使えないため、v3 を使用
(※Keystone : OpenStack Identity サービス)
- trove*.conf で
cinder_url = http://controller:8776/v1となっているところは
cinder_url = http://controller:8776/v2としないとうまく動かなかった- OpenStack(Queens 版)では Cinder の API v1 は使えないため、v2 / v3 を使用
(※Cinder : OpenStack Block Storage サービス)
- OpenStack(Queens 版)では Cinder の API v1 は使えないため、v2 / v3 を使用
- trove-guestagent.conf で
- OpenStack の region 設定をデフォルトから変えている場合は、デフォルト値 RegionOne が自動的に選ばれないよう、
os_region_nameを明示的に設定する - trove-guestagent.conf で URL やホストを指定しているその他の箇所も、Trove guest agent 環境からの名前解決を不要とするために IP アドレスでの指定が必要
- 導入手順に示されていないが、Trove guest agent ファイルをコントローラーノードへ配置し、また、接続のための ssh キーを登録する手順が必要
- 導入手順に示されていないが、Trove guest agent ファイルが実行可能となるように、Trove guest agent ファイルのディレクトリ配下で
python setup.py egg_infoなどの実行が必要 - trove-guestagent.conf で
rabbit_userid = openstack設定の追加が必要 - trove.conf で
network_label_regex = ^NETWORK_LABEL$となっているが、
network_label_regex = .*に修正が必要
- URL 等の記載が実際の設定内容と異なっているものがある
-
Trove のログ機能で必要になるため、OpenStack オブジェクト・ストレージ・サービス Swift の swift-object-expirer プロセスが起動していなかったら、各種設定を行い起動しておく必要がある
Trove のプロセス構成
Trove で、起動イメージの動作確認で想定どおりの動きをしないなどの問題が起きたときに、複数のプロセスが内部でどのように相互作用をして動いているのかを意識して解析できるために、Trove のプロセス構成について説明します。
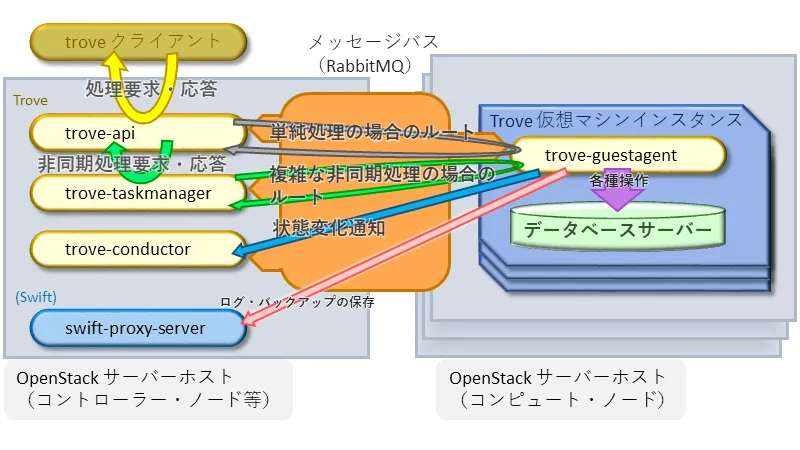
Trove では、以下のプロセスが協調して動作しています。
| プロセス | 実行環境 |
|---|---|
| Trove-api | OpenStack サーバーホスト上(コントローラーノード等) |
| Trove-taskmanager | OpenStack サーバーホスト上(コントローラーノード等) |
| Trove-guestagent | Trove の提供するデータベースサーバーが動作するすべての仮想マシンインスタンス上 |
| Trove-conductor | OpenStack サーバーホスト上(コントローラーノード等) |
Trove-api
trove-api は、データベースサーバーの起動や管理をする機能を提供する RESTful な API サーバーです。trove-api 自身は重い処理を行わず、複雑な非同期タスクを処理するためには trove-taskmanager と通信をし、単純なタスクを処理するためには trove-guestagent と直接通信して、リクエストを転送します。
Trove-taskmanager
trove-taskmanager は、データベースサーバーが動作する仮想マシンインスタンスの起動と実行管理、および仮想マシンインスタンス上での各種操作など、複雑で手間が掛かる一連の作業を実行します。 trove-taskmanager は trove-api からリクエストを受け取ると、応答を返し、複雑な非同期タスクを開始します。処理の中で、trove-guestagent へのリクエストの送信も行われます。
Trove-guestagent
trove-guestagent は、データベースサーバーが動作するすべての仮想マシンインスタンス上で動作し、データベース自体の操作や管理を担当します。データストアの種類により、具体的な処理の内容は変わってきます。trove-guestagent は、リクエストを受信し、要求された処理を実行します。また、trove-conductor にハートビートメッセージも送信します。
※trove-guestagent は、そのほかにも、データベースログやデータベースバックアップの保存処理のために、OpenStack オブジェクト・ストレージ・サービス(Swift)の API サーバーとも通信できる必要があります。
Trove-conductor
trove-conductor は、OpenStack サーバーホスト上で実行され、trove-guestagent からメッセージを受信してホスト上の情報を更新します。たとえば、ハートビートによるデータベースの状態(NEW/BUILDING/ACTIVE など)通知がこれに該当します。
データベースサーバー起動イメージについて
Trove のデータベースサーバー起動イメージには、特定のデータベースサーバーが起動するための仕組みと、trove-guestagent が起動するための仕組みが組み込まれており、起動イメージから仮想マシンが作成され、起動されると、これらの初期化処理が実行されることになります。
次回予告
Trove 導入入門編では、今後の準備として、Trove の紹介と導入作業の流れ、および登場する Trove のプロセスについて説明しました。次回はいよいよ、起動イメージ作成についての説明に入っていきます。Trove の起動イメージの作成には、Diskimage-builder というツールを使うことになっています。Diskimage-builder は、elements と呼ばれる部品を使って、起動イメージのファイルに必要な機能を組み込んでいきます。Trove 機能を組み込むために、Trove からも追加の elements が提供されています。これらを使って起動イメージを作り上げていくのですが、いざイメージができあがってみると、なかなか期待したよう機能が動いてくれないこともあります。その都度、Trove プロセスやデータベースサーバーなどの動きを解析し、問題を切り分け、解決していくことになるのですが、このあたりのことについても触れていきたいと思います。
記事の執筆にあたっては情報の正確性に努めておりますが、掲載されている文章やソースコード、設定ファイル等の内容について、完全な正確性や安全性を保証するものではありません。活用される際は、必ず公式ドキュメント等をご自身で確認のうえご判断ください。